Что команда выложила 3 ноября
Kandinsky Lab, исследовательская команда Сбера, открыла Kandinsky S2V 1.0. Аббревиатура расшифровывается как speech-to-video: на вход идёт один опорный кадр, готовая речевая дорожка и текстовый промпт, а на выходе человек с этого кадра говорит и двигается в такт записи.
Код лежит на GitHub под лицензией MIT, веса подтягиваются с Hugging Face автоматически при первом запуске. Файл Pro в bf16 весит 39,8 ГиБ, так что скачивание это отдельное мероприятие, особенно если канал не гигабитный.
Версий две. Lite держится около 2 млрд параметров, Pro тянет 21,4 млрд и 60 визуальных блоков DiT. К ним приложены дистиллированные сборки: дистиллированная Pro обходится 16 шагами семплирования, и по замерам команды это ускоряет генерацию примерно в 5,4 раза.
API нет, прайса нет. Это первое, что стоит помнить, когда читаешь восторги под анонсом.
Как устроен говорящий аватар нейросеть
Связка собрана из готовых и своих блоков, и это скорее хорошо. Qwen2.5-Omni-7B читает сразу и промпт, и речь: одна модель понимает, что просят и что произносят. CLIP ViT-L/14 отвечает за опорный кадр. 3D VAE взят из HunyuanVideo, он и переводит картинку в латентное пространство, с которым работает диффузия.
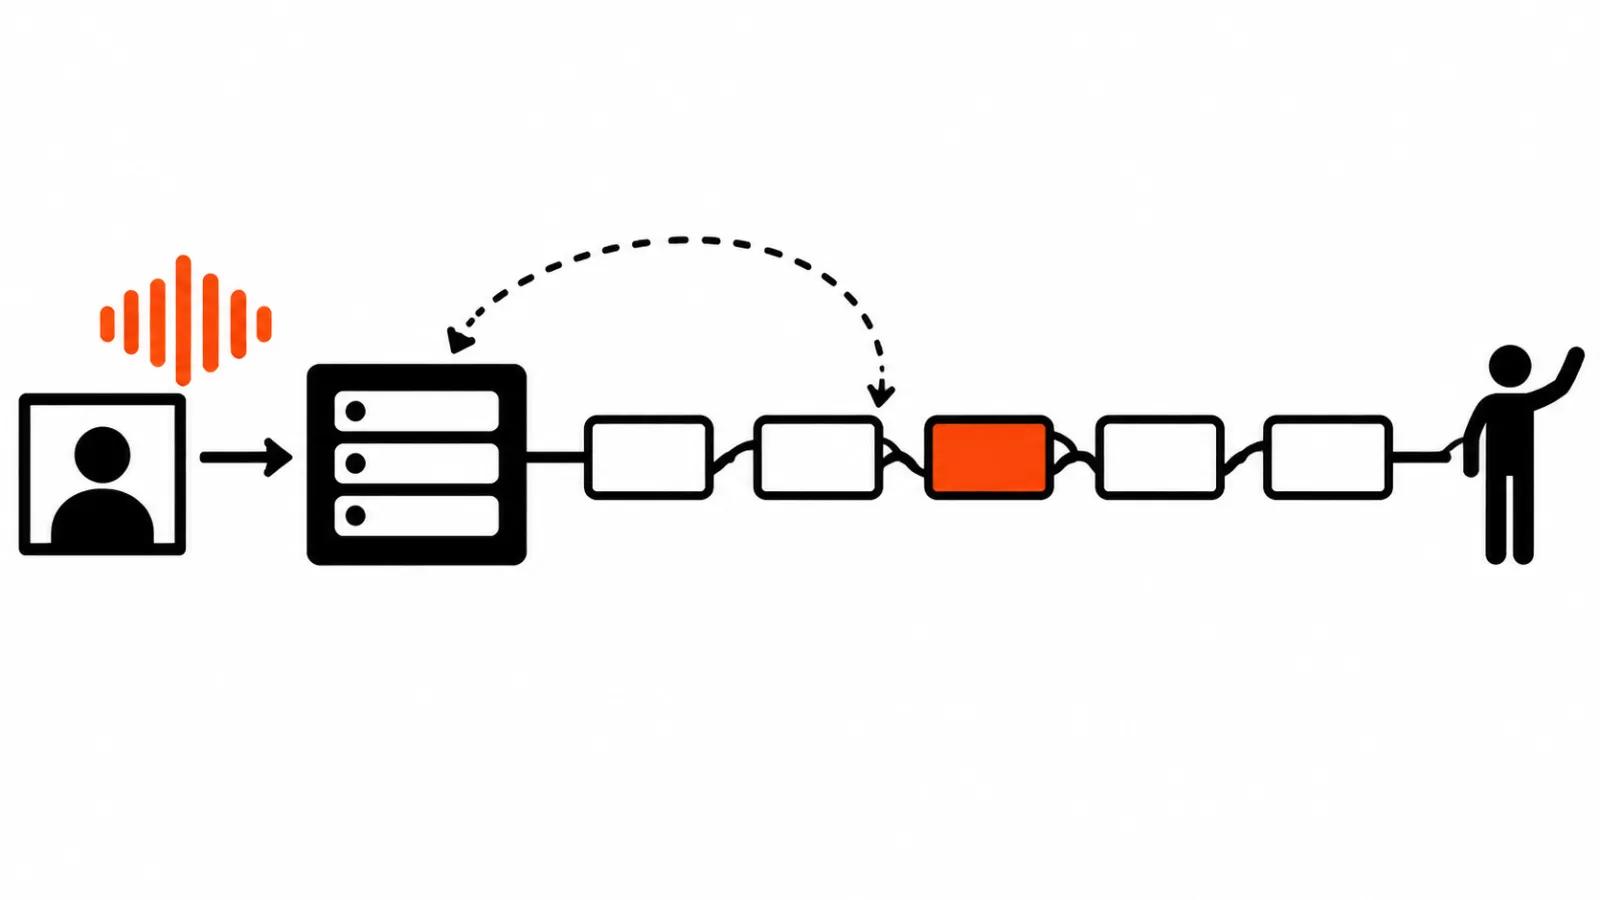
Речь входит в генератор через адаптеры кросс-внимания в 18 блоках DiT. Каждый кадр смотрит на свой кусок звука, поэтому артикуляция привязана к конкретному моменту дорожки. Память FramePack переносит контекст между кусками, и пятисекундные фрагменты склеиваются в непрерывное движение без рывка на стыке.
Для практики важен вывод из архитектуры: модель не учится говорить заново, она подстраивает картинку под уже готовый звук. Значит качество озвучки задаёт диктор, модель его только повторяет.
Оживить фото с голосом: что на входе и что на выходе
Вход простой. Хватит одной фотографии, по грудь или в полный рост, снятой при ровном свете. Дальше речевая дорожка: модель её не создаёт, звук подаётся готовым, а синтезом речи занимаются отдельные инструменты.
Двигается вся фигура. Голова, плечи и руки ходят вместе с мимикой, на демо человек переступает с ноги на ногу, жестикулирует, поворачивает корпус. На фоне обычного липсинка это заметная разница, потому что там оживает маска лица, а тело остаётся фотографией.
Промпт задаёт сцену и манеру: попросить говорить спокойно, держать руки на столе, смотреть в камеру. Управление грубое, но для рекламного ролика на двадцать секунд его хватает.
Выход: 25 кадров в секунду, разрешение SD или HD, пропорции как у опорного кадра. Длинную речь модель собирает кусками по 5 секунд, так что монолог на две минуты это двадцать с лишним проходов и столько же склеек.
На странице проекта есть примеры на других языках, с мультяшными персонажами, животными и длинными роликами. Языки команда не скрывает: в статье обучение шло на подписях на английском и русском.
Скорость: минута ролика это три часа на одной H100
Таблица команды читается будто медленно, а на деле это нормальный порядок для видео-диффузии. Минута SD-ролика на одной карте займёт около трёх часов. Тот же ролик в HD растянется примерно на тринадцать часов, если считать по их же цифрам.
Восемь карт меняют картину: минута SD сжимается до получаса с небольшим. Но аренда восьми H100 тоже стоит денег, и считать надо полный цикл с ретраями, секунды генерации сами по себе мало что значат.
Ретраи будут. Любая видео-диффузия выдаёт брак, и на длинной речи процент брака растёт: где-то поплыло лицо, где-то рука прошла сквозь стол. Реальная стоимость минуты готового материала выше табличной в полтора-два раза, и это моя оценка по опыту соседних моделей, команда таких цифр не публиковала.
| Режим | Секунд на секунду видео |
|---|---|
| SD, одна H100, пик 46 ГиБ | 189 |
| HD, одна H100, пик 55 ГиБ | 773 |
| SD, восемь H100 | 32 |
Что с качеством, правами и русским языком
Качество пока подтверждено только тестами самой команды. Независимых прогонов и слепых сравнений нет, цифра про 5,4 раза тоже их собственный замер. На демо всё выглядит прилично, но демо всегда выбирают руками.
Обучение шло на большом наборе роликов с подписями на английском и русском, в статье указано около 1,17 млн клипов. Для русского сегмента это редкость: большинство открытых аватаров приезжают из англоязычных датасетов и разваливаются на наших согласных.
Авторы отдельно просят брать кадры только людей с их согласия и не выдавать результат за настоящую запись. Просьба по делу, потому что инструмент уже сейчас делает правдоподобное видео с любым лицом, на которое есть одно фото.
С этой же проблемой связан наш разбор про аватар в реальном времени: там модель работает на своём железе с задержкой в доли секунды, и сценарии совсем другие, живой разговор вместо записанного монолога. Отдельно мы собирали обзор сервисов аватаров, где главное это подписка, лимиты минут и правила по лицам.
Мой вывод: инструмент студии, который не станет приложением
Хорошая новость в свободе. Свой аватар без подписки, без лимита на минуты и без отправки лиц в чужое облако: веса лежат на диске, генерация идёт на вашей карте. Для тех, кто снимает обучающие ролики и не готов отдавать биометрию сервису, это меняет правила игры. Русский язык в обучении тоже важен, потому что местный рынок до сих пор собирал аватаров из чужих англоязычных сборок.
Плохая новость в железе. 39,8 ГиБ весов, 55 ГиБ пика памяти в HD и три часа на минуту SD-ролика: это рабочее место студии с арендой GPU. Кнопкой в телефоне Kandinsky S2V не станет, и в этом её отличие от подписочных сервисов.
Бизнесу считать просто. Пока нужен ролик раз в месяц, дешевле снять его руками или взять готовый сервис, чем держать карту под нагрузкой. Когда в кадре человек, который произносит текст компании, задачу закрывает говорящий аватар из одного кадра: мы собираем такие видео под ключ, с подбором кадра, озвучкой и монтажом. Второй путь, видео нейросетями по сценарию, годится там, где аватар только часть сцены.
И третье: про Kandinsky 6 для видео у нас есть отдельный разбор, и S2V дополняет её там, где в кадре нужен говорящий человек. Один опорный кадр, одна речь, один промпт: на таком наборе модель показывает то, на что способна, а дальше начинается работа со звуком и монтажом.